Что такое синтетические данные?
Синтетические данные для тестирования – это данные, которые создают искусственно, чтобы они вели себя как настоящие: повторяли распределения, пропорции, редкие и крайние случаи, но не содержали персональных данных реальных людей. Они нужны для четырех разных задач – нагрузочного тестирования, регресса, обучения моделей и демо.
Подход зависит от задачи: где-то хватит пяти тысяч строк на фикстурах, где-то нужен конвейер генерации 4 ТБ с проверкой по статистике, планам запросов и приватности. Юридическая сторона при этом определяет стоимость. Маскирование с обратимым ключом остается персональными данными по 152-ФЗ1. Синтез выводит данные из-под закона, только если доказано, что связь с реальными людьми отсутствует, – с 1 сентября 2026 года это проверяется по национальным стандартам ПНСТ 1064–10662.
Наш ведущий эксперт Олег подготовил цикл из трех материалов, в которых пошагово рассказывает, как построить конвейер, который выдает обезличенные данные в промышленных объемах, и как убедиться, что они не врут. Никакой магии – только метрики, пороги и грабли, на которые он уже наступал. Полезно для руководителей разработки и QA, продакт-менеджеров и всех, кто работает с тестовыми данными.
Публикуем первую часть, речь в которой пойдет о стратегии и границах. Вы узнаете, какие бывают тестовые данные, насколько реалистичными их можно делать и что по этому поводу говорит закон.
Понедельник, планерка. Тестировщик разводит руками: у меня не воспроизводится, на моих данных все зеленое. Аналитик говорит, что у него выгрузка трехмесячной давности и новых статусов заявки там еще нет. Нагрузочник молчит – у него стенд на 40 ГБ против 6 ТБ прода, и он давно перестал верить собственным графикам. А безопасник в этот момент пишет письмо о том, что дамп боевой базы опять оказался на ноутбуке подрядчика. Если у вас такого никогда не бывало – вы либо совсем маленькие, либо уже очень взрослые. В обоих случаях дальше можно не читать.
Я лет десять кручусь вокруг тестовых сред, и первые года три делал ровно то, что делают все: выгружал из прода двести тысяч строк, менял фамилии на Иванов1, Иванов2 и так далее, и считал, что обезличил. Пока не заметил, что в выгрузке остались номера договоров. А по номеру договора на нашей же публичной форме проверки статуса доставался город и последние четыре цифры телефона. Это был не взлом – это была форма на сайте, которую мы сами и сделали. Мне повезло, что очень быстро именно я нашел ее первым.
С тех пор я отношусь к тестовым данным как к проду: с той же паранойей и тем же уровнем проектирования. Ниже – методология, которой хватает и на регресс из 5 000 строк, и на нагрузочный контур в 4 ТБ.
Пара цифр для контекста, чтобы было понятно: проблема не выдуманная. По опросу «Гарды»3 среди российских компаний специализированные средства маскирования применяют около 3% респондентов, почти половина регулярно переносит в тестовые среды копии продуктивных баз без изменений, а 18,8% держат тестовые базы в том же кластере, что и боевую. При этом с 30 мая 2025 года по 420-ФЗ4 утечка данных 1 000–10 000 человек стоит юрлицу от 3 до 5 млн рублей, а повторная – от 1 до 3% годовой выручки, минимум 25 млн. Это уже не риски информационной безопасности, это строчка в P&L.
Какие задачи решает создание тестовых данных и чем они отличаются?
Самая дорогая ошибка здесь скрывается на старте, и стоить она может около 6 месяцев бесполезной работы. Звучит так: давайте сделаем нормальные тестовые данные, но без уточнения, для чего. Я вам расскажу про четыре основных задачи с несовместимыми требованиями, которые могут прятаться за таким расплывчатым запросом. Данные, отличные для регресса, бесполезны для нагрузочного тестирования, а данные, на которых обучается скоринг, не подойдут для демо партнеру. И наоборот. Обязательно прочитайте, чтобы не пойти по ложному направлению с самого начала, так как переделывать будет очень дорого.
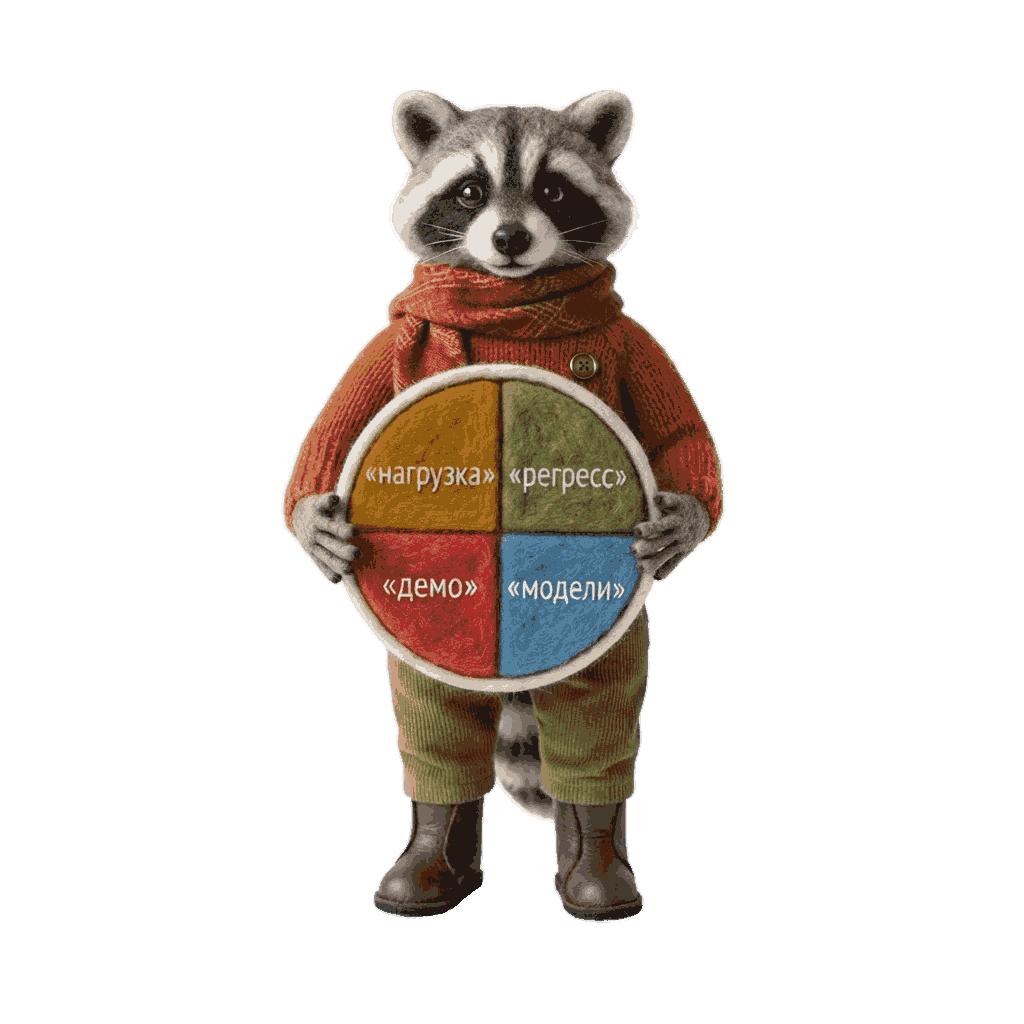
Девять из десяти компаний говорят одно и то же: нам нужны тестовые данные. Я на проекте сразу собираю всех и прошу разложить по таблице, кому что нужно. Почти всегда оказывается, что спорили люди о разных вещах.
Мой любимый антипаттерн: команда полгода строит пайплайн на CTGAN, покупает видеокарты, а нужны были пять тысяч строк для регресса, где важно только одно – чтобы у клиента было от нуля до семи карт. Это делается за два дня на фикстурах. Бывает и наоборот, и это дороже: под нагрузочное тестирование берут данные, сделанные для демо. Чем это кончается – обязательно расскажу на примере кейсов в третьей статье цикла. Был случай, когда p99 на стенде отличался от прода в двадцать три раза.
Что делать прямо сейчас?
Соберите всех, кто работает с тестовыми данными, и попросите каждого назвать одну метрику, по которой он поймет, что данные плохие. Не общие слова про реалистичность, а конкретно: доля отказов по эквайрингу – 2,8% ± 0,3. Если человек не может назвать такую метрику – значит, у него не требования, а ощущения. А ощущения меняются каждый спринт, работать с ними нельзя.
Что такое синтетические данные и какие уровни реалистичности бывают?
Часто синтетические данные понимают, как что-то одно, а на самом деле это целый спектр от пустых заглушек с правильными типами полей до почти полной копии прода. И кстати, чем ближе к копии, тем больше от них толку – но тем рискованнее с точки зрения утечек. Это не баг технологии, так устроено само явление.
Британское статистическое ведомство (ONS)5 предложило шкалу из шести уровней – самую вменяемую из тех, что я видел. Подготовил для вас удобную таблицу и добавил от себя столбец «для чего годится»: в оригинале его нет, но так нагляднее и полезнее.
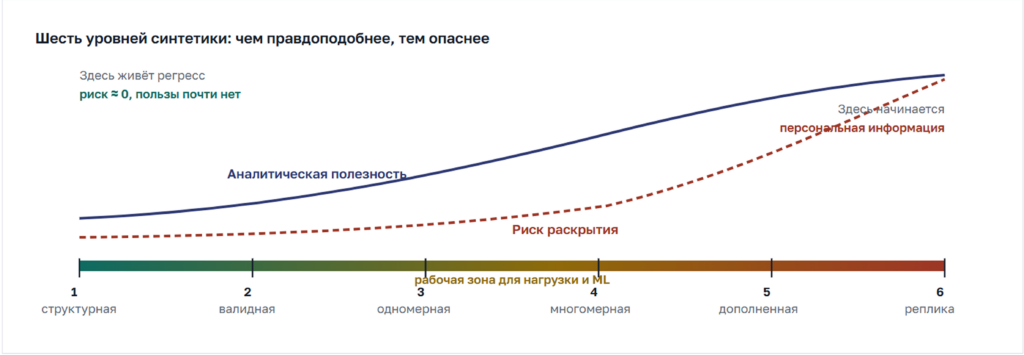
Уровень выбирается под задачу из первой таблицы, а не под амбиции команды. Для регресса хватает второго, для нагрузочного тестирования нужен четвертый, для машинного обучения – пятый. Шестой в корпоративной практике почти никогда не нужен. Если его продают под тестирование – продают лишний риск.
Ошибка из практики
Как-то раз мы сделали для нагрузочного стенда пятый уровень – просто потому что могли. Через месяц пришел безопасник и спросил: на каком основании данные пятого уровня лежат в контуре, куда имеют доступ двенадцать подрядчиков? И был прав. Мы потом три недели доказывали, что из этих данных невозможно вытащить реальных людей. А по задаче вполне хватало четвертого уровня и недели работы.
Вывод простой: лишнее качество синтетики не всегда оправдано. Ты берешь на себя лишний риск – и потом за него отвечаешь.
Маскирование, псевдонимизация и синтез – чем они отличаются с юридической точки зрения?
Этот раздел я проговариваю с юристом и безопасником на первой же встрече – от него зависит стоимость всего проекта. Разница между тремя подходами не техническая, а правовая. И путают их постоянно.
Маскирование с обратимым ключом – это псевдонимизация. Вы заменили фамилию на код, а ключ положили в хранилище. Субъекта вроде не определить – но только пока ключа нет. А он есть. Значит, это по-прежнему персональные данные, тестовый контур остается ИСПДн со всеми требованиями к защите, и штрафы за утечку из него ложатся на вас.
Обезличивание регулируется жестко. С 1 сентября 2025 года действует приказ Роскомнадзора № 140 от 19.06.20256 – он заменил прежний № 996 от 2013 года. Методы в целом те же: идентификаторы, изменение состава и семантики, перемешивание, декомпозиция – плюс добавился новый метод преобразования массива. Но важнее методов требования к самому процессу, а их как раз редко кто читает.
Что требует приказ № 140 и что из этого ломает привычную практику:
- Нельзя хранить обезличенные данные вместе с исходными. Схема, когда в одной базе рядом лежат clients и clients_masked, – вне закона. А так делают почти все.
- Ключ соответствия хранится отдельно и третьим лицам не передается. Подрядчик по нагрузочному тестированию – это третье лицо.
- Локальные акты о методах обезличивания и о применяемых системах не должны быть доступны третьим лицам. То есть описание вашего пайплайна маскирования само по себе – чувствительный документ.
- Ведется учет всех действий. Каждая выгрузка сопровождается журналом.
Синтез – совсем другое дело. Вы не переделываете записи реальных людей, а создаете новые. Нет записи, которая соответствует конкретному человеку, – нет и персональных данных. Но это нужно доказывать, а не просто заявлять.
И тут стало проще. Росстандарт выпустил первые стандарты по синтезу данных – их подготовила Ассоциация больших данных. Три документа: ПНСТ 1064-2026 – основные понятия и термины, ПНСТ 1065-2026 – архитектура и методы синтеза, ПНСТ 1066-2026 – оценка качества результатов. Действуют с 1 сентября 2026 года, то есть уже сейчас. Там наконец-то есть то, чего не хватало: как оценить достоверность, как измерить риск восстановления исходных данных, как валидировать, как маркировать и аудитировать.
На практике вывод простой: сама фраза про синтетические данные больше ничего не доказывает. Безопасники не будут спрашивать, уверены ли вы – они захотят увидеть отчет по качеству. И это хорошо: наконец-то можно перестать спорить о вкусах и говорить на языке цифр.
А как с этим обстоят дела за рубежом?
Если нужно обосновать подход для зарубежной части группы, логика везде одна: смотрят не на название метода, а на остаточный риск повторной идентификации. GDPR7 (соображение 26) и заключение WP29 05/20148 требуют закрыть три риска – выделение записи, связывание и вывод атрибута. Остался хоть один – это уже не анонимизация. Самый практичный документ – NIST SP 800-1889, финальная редакция от сентября 2023. Там же описаны совет по проверке раскрытия и тест мотивированного нарушителя. В HIPAA10 две дорожки: удалить 18 атрибутов из списка или провести экспертную оценку риска. Российская практика по факту дрейфует ко второй.
Отдельная работа для всех, кому синтетику продают как серебряную пулю: Stadler, Oprisanu, Troncoso, Synthetic Data – Anonymisation Groundhog Day, USENIX Security 202211. Вывод неудобный: сама по себе синтетика не дает лучшего баланса между приватностью и полезностью, чем классическая анонимизация. Либо теряете полезность, либо защищаете не все записи, а предсказать заранее, где окажетесь, трудно. Отсюда единственный рабочий вывод: не верить, а измерять.
Еще две цифры на случай, если кто-то думает, что убрал ФИО и теперь безопасно. Латания Суини12 еще в девяностых показала: около 87% американцев однозначно определяются по связке индекса, даты рождения и пола. Rocher, Hendrickx и de Montjoye в Nature Communications за 2019 год оценили13, что 99,98% американцев можно переопределить по пятнадцати демографическим атрибутам, причем даже на сильно прореженных выборках. Пятнадцать атрибутов есть в любой таблице клиентов.
На чем в итоге сходится большинство зрелых команд: нейросеть отвечает за структуру; правила – за форматы и ключи; каталог патологий – за редкие и проблемные случаи. Про дифференциальную приватность скажу отдельно: она нужна, когда данные уходят наружу, и почти никогда – когда остаются внутри вашего контура.
Главный вывод первой части
Закон не запрещает работать с тестовыми данными – он запрещает работать с ними небрежно. Граница между псевдонимизацией, обезличиванием и синтезом не техническая, а правовая, и цена ошибки здесь не часы переделки, а оборотные штрафы и репутация. Приказ Роскомнадзора № 140, стандарты Росстандарта по синтезу, требования GDPR и HIPAA – все сходится в одном: документально доказанный остаточный риск повторной идентификации. Не название метода и не уверенность на совещании, а отчет, который можно положить на стол аудитору.
Во второй части разберем практику. Семь шагов запускка конвейера данных – от инвентаризации, которую все хотят пропустить, до тройных ворот валидации. Расскажу, как собрать двухконтурную схему для терабайтных объемов, почему нейросеть отвечает за структуру, а правила – за контрольные суммы и хвосты.
В третьей части поделюсь тремя историями из практики с разбором ошибок. Расскажу, что делать с российской спецификой и какой стек инструментов актуален для нашей страны: от открытых библиотек до коробочных решений. А еще поговорим о деньгах: покажу, как сделать расчет экономики, который убеждает финансистов, и дам честный порог, ниже которого весь этот конвейер просто не нужен.
Мы в «Лаборатории качества» во время аудитов находим в среднем от двух до пяти проблем в тестовых контурах, о которых команды заказчиков даже не подозревали. Иногда это забытая выгрузка с реальными телефонами, иногда – маскирование, которое юридически не обезличивает ничего. Хотите узнать, все ли на вашем проекте в порядке? Запишитесь на бесплатную консультацию. Разберем ваш кейс и ответим на вопросы.
Вопросы и ответы
Чем отличаются тестовые данные от боевых?
Боевые данные – это реальные записи людей и организаций, используемые в продуктиве. Их утечка влечет штраф по 152-ФЗ до 1–3% выручки (мин. 25 млн руб к повторной утечке спец категорий и биометрии, для общих данных минимум – 20 млн). Тестовые данные нужны для отладки и нагрузочного тестирования. Они не являются персональными данными, так как не позволяют идентифицировать субъекта, и для работы с ними не требуют прохождения процедур ИСПДн, если они получены синтетическим путем.
Можно ли тестировать на копии продакшн-базы?
Копия базы продакшена содержит персональные данные и подпадает под действие 152-ФЗ. По Приказу Роскомнадзора № 140 хранить исходные и обезличенные данные в одной системе запрещено. Передача копии базы подрядчику или выгрузка в незащищенный тестовый контур незаконны. Чтобы тестировать на копии, необходимо предварительно провести полное обезличивание или псевдонимизацию с выносом ключей в отдельное защищенное хранилище.
Что такое синтетические данные и чем они отличаются от маскирования?
Маскирование подменяет значения в реальных записях, сохраняя связь с реальным субъектом. Ключ обратимости означает, что данные остаются персональными. Синтез генерирует новые, вымышленные записи на основе статистических паттернов оригинала. Связи с реальным человеком нет, поэтому данные не являются ПДн. Но отсутствие утечки необходимо подтверждать: по стандартам ПНСТ 1064-1066 предоставляется отчет об оценке качества и остаточного риска приватности.
Чем маскирование отличается от обезличивания по закону?
Маскирование с сохранением обратимого ключа – это псевдонимизация. Данные остаются персональными по 152-ФЗ, а система – ИСПДн. Обезличивание по Приказу Роскомнадзора № 140 – это необратимое преобразование, когда личность нельзя установить ни при каких условиях. Оно требует строгого раздельного хранения исходных и преобразованных данных и ведения учета каждой выгрузки, так как полностью выводит данные из-под ответственности оператора ПДн.
Тренды и фишки из мира IT,
экспертные статьи и всё о тестировании.
- Федеральный закон от 27.07.2006 № 152-ФЗ «О персональных данных» (с изм. и доп.). – Текст : электронный // КонсультантПлюс : сайт. – URL: https://www.consultant.ru/document/cons_doc_LAW_61801/ (дата обращения: 17.09.2026). ↩︎
- ПНСТ 1064-2026, ПНСТ 1065-2026, ПНСТ 1066-2026. Синтез данных : предварительные национальные стандарты Российской Федерации. – Введ. 01.09.2026. – Текст : электронный // Институт стандартизации : сайт. – URL: https://www.gostinfo.ru/catalog/Details/?id=8381073 (дата обращения: 17.09.2026). ↩︎
- Гарда. Почти половина компаний переносит данные в тест без маскирования : опрос / Гарда. – Текст : электронный // РБК Компании : сайт. – URL: https://companies.rbc.ru/news/R9ejwT3fZR/garda-pochti-polovina-kompanij-perenosit-dannyie-v-test-bez-maskirovaniya/ (дата обращения: 17.09.2026). ↩︎
- Федеральный закон от 30.11.2024 № 420-ФЗ «О внесении изменений в Кодекс Российской Федерации об административных правонарушениях» (оборотные штрафы за утечки персональных данных). – Текст : электронный // Контур : сайт. – URL: https://kontur.ru/aegis/blog/56638-shtrafy_v_sfere_informacionnoj_bezopasnosti (дата обращения: 17.09.2026) ↩︎
- Office for National Statistics. ONS methodology working paper series number 16 – Synthetic data pilot / ONS. – Newport : Office for National Statistics, 2019. – Текст : электронный // ONS : сайт. – URL: https://www.ons.gov.uk/methodology/methodologicalpublications/
generalmethodology/onsworkingpaperseries/onsmethodologyworkingpaperseriesnumber
16syntheticdatapilot (дата обращения: 17.09.2026). ↩︎ - Приказ Роскомнадзора от 19.06.2025 № 140 «Об утверждении требований к обезличиванию персональных данных и методов обезличивания персональных данных». – Зарегистрировано в Минюсте России 31.07.2025 № 83110. – Текст : электронный // Официальный интернет-портал правовой информации : сайт. – URL: http://publication.pravo.gov.ru/document/0001202508010002 (дата обращения: 17.09.2026). ↩︎
- GDPR. Recital 26 – Регламент (ЕС) 2016/679 Европейского парламента и Совета от 27 апреля 2016 г. о защите физических лиц при обработке персональных данных и о свободном обращении таких данных (Общий регламент по защите данных). – Текст : электронный // IAPP : сайт. – URL: https://iapp.org/news/a/looking-to-comply-with-gdpr-heres-a-primer-on-anonymization-and-pseudonymization (дата обращения: 17.09.2026). ↩︎
- Article 29 Working Party. Opinion 05/2014 on Anonymisation Techniques (WP216). – Brussels : European Commission, 2014. – 26 p. – Текст : электронный // Закон.ру : сайт. – URL: https://zakon.ru/blog/2021/11/5/obezlichivanie_personalnyh_dannyh_v_rossii_i_v_evrope_
kogda_dannye_perestayut_byt_personalnymi (дата обращения: 17.09.2026). ↩︎ - NIST Special Publication 800-188. De-Identifying Government Datasets: Techniques and Governance / National Institute of Standards and Technology. – Gaithersburg, MD : NIST, 2023. – 112 p. – DOI: 10.6028/NIST.SP.800-188. – Текст : электронный // NIST : сайт. – URL: https://www.nist.gov/news-events/news/2023/09/de-identifying-government-datasets-techniques-and-governance-nist-publishes (дата обращения: 17.09.2026). ↩︎
- HIPAA Privacy Rule. Safe Harbor Method – 18 identifiers / U.S. Department of Health & Human Services. – Текст : электронный // CASRAI : сайт. – URL: https://casrai.org/guides/18-hipaa-identifiers (дата обращения: 17.09.2026). ↩︎
- Stadler, T. Synthetic Data – Anonymisation Groundhog Day / T. Stadler, B. Oprisanu, C. Troncoso // 31st USENIX Security Symposium (USENIX Security 22). – Boston, MA : USENIX Association, 2022. – P. 1451–1468. – Текст : электронный // USENIX : сайт. – URL: https://www.usenix.org/conference/usenixsecurity22/presentation/stadler (дата обращения: 17.09.2026). ↩︎
- Sweeney, L. Simple Demographics Often Identify People Uniquely / L. Sweeney. – Pittsburgh, PA : Carnegie Mellon University, Data Privacy Working Paper 3, 2000. – Текст : электронный // Forbes : сайт. – URL: https://www.forbes.com/sites/adamtanner/2013/04/25/harvard-professor-re-identifies-anonymous-volunteers-in-dna-study/ (дата обращения: 17.09.2026). ↩︎
- Unique in the Shopping Mall: On the Reidentifiability of Credit Card Metadata / Y.-A. de Montjoye, L. Radaelli, V. K. Singh, A. Pentland // Science. – 2015. – Vol. 347, № 6221. – P. 536–539. – DOI: 10.1126/science.1256297. – Текст : электронный // ScienceDaily : сайт. – URL: https://www.sciencedaily.com/releases/2019/07/190723110523.htm (дата обращения: 17.09.2026). ↩︎